
Chat
Schnelle Streaming-Unterhaltungen
Wähle ein beliebiges GGUF-Modell — lade es aus dem integrierten Katalog herunter oder öffne eine Datei von deinem Gerät. Markdown, Codeblöcke und Verlauf inklusive.
Chatten, sehen, hören und kreieren — mit Modellen, die auf Handy, Laptop und im Browser laufen. Kein Konto. Keine Werbung. Deine Prompts verlassen dein Gerät nie, es sei denn, du willst es.
Llamatik holen
Starte im Browser-Tab und nimm sie dann überallhin mit. Gleiche Chats, gleiche Modelle, gleiche Privatsphäre.
Keine Installation. Läuft im Browser mit WebAssembly.
Web-App öffnen →Google Play · Android 8.0+
Jetzt bei Google Play →App Store · iOS 16.6+
Im App Store laden →Apple Silicon & Intel · .dmg
Für Mac laden →Windows 10+ · .msi
Für Windows laden →Debian & Ubuntu · .deb · Omarchy
.deb laden →Jedes Desktop-Release enthält SHA-256-Prüfsummen. Alle Downloads & Prüfsummen →
Was sie kann
Text, Vision, Sprache, Bilder, Video und Dokumente — jeweils auf der Engine, der du schon vertraust, und auf der Hardware, die du schon hast.
Wähle ein beliebiges GGUF-Modell — lade es aus dem integrierten Katalog herunter oder öffne eine Datei von deinem Gerät. Markdown, Codeblöcke und Verlauf inklusive.
Stell Fragen zu Fotos, Screenshots und Dokumenten — mit On-Device-Visionsmodellen wie SmolVLM.
Whisper transkribiert Sprache offline — mit Zeitstempeln, Übersetzung ins Englische und Sprecherwechseln.
Beschreibe eine Szene und erhalte einen kurzen Clip — kodiert in H.264, in deiner Galerie gespeichert, optional mit On-Device-Upscaling.
Text-zu-Bild und Bild-zu-Bild, mit Live-Fortschritt und ControlNet-Steuerung für Pose, Tiefe und Kanten.
Planer, Tools, Berechtigungen und ein Audit-Protokoll — mit Begleiter-Personas von Professional bis Pet.
Lokales RAG: Chunking, Embeddings und MMR-Retrieval — deine Dateien werden nie hochgeladen.
Spekulatives Drafting für unterstützte Modelle (Qwen3.5, GLM-4) — mehr Tokens pro Sekunde.
Modelle und Chats bleiben auf deinem Gerät. Kein Konto, keine Werbung, optionale Diagnose, die standardmäßig aus ist, und eine klare Warnung, bevor du dich jemals mit einem Server verbindest.
Gerät teilen neu in 2.0
Dein Gaming-PC hat die Power. Dein Handy hat dich. Aktiviere Gerät teilen und Llamatik stellt deine geladenen Modelle deinen anderen Geräten im lokalen Netzwerk bereit — automatisch gefunden per mDNS.
Verbindungen zwischen Geräten laufen derzeit über unverschlüsseltes HTTP — nutze sie nur in Netzwerken, denen du vertraust.
Llamatik 2.0
Die App ist das Schaufenster. Die Engine darunter ist jetzt ein vollwertiges Kotlin-Multiplatform-KI-SDK.
Chat, Modelle, Downloads, RAG und die neue Assistant-Fassade — ohne UI und veröffentlichbar.
Eine Kotlin-DSL und eine AgentRuntime mit Berechtigungen, Bestätigungen und Audit.
Text-zu-Video, ControlNet, Live-Fortschritt und Video-Upscaling.
Multimodale Bildanalyse über libmtmd — SmolVLM und Co.
Mit Servern verbinden, Knoten entdecken und das eigene Gerät teilen.
Basiert auf den neuen, semantisch versionierten Releases von llama.cpp und whisper.cpp.
Für Entwickler
Derselbe Stack, der die Llamatik-App antreibt, liegt auf Maven Central. Eine Kotlin-API für Android, iOS, Desktop und WASM — kein Python, kein Glue-Code.
Klick auf ein Modul, um seine Gradle-Zeile zu kopieren.
val agent = Agent {
    name("Kotlin Assistant")
    systemPrompt("You are an expert Kotlin developer.")
    temperature(0.7f)
    memory(SlidingWindowMemory(windowSize = 20))
    tools { builtIns() }   // calculator, date/time, uuid, random
}

agent.stream("What is 17% of 2,340?").collect { chunk ->
    when (chunk) {
        is AgentStreamChunk.Delta -> print(chunk.text)
        is AgentStreamChunk.Done  -> println()
        else -> Unit
    }
}
val path = LlamaBridge.getModelPath("phi-2.Q4_0.gguf")
LlamaBridge.updateGenerateParams(
temperature = 0.7f, maxTokens = 512,
topP = 0.95f, topK = 40, numThreads = 4,
)
LlamaBridge.initGenerateModel(path)
// Same call on Android, iOS, Desktop and WASM
val answer = LlamaBridge.generate(
"Explain Kotlin Multiplatform in one sentence."
)commonMain.dependencies {
// llama.cpp, whisper.cpp, stable-diffusion.cpp — one Kotlin API
implementation("com.llamatik:core:<version>")
// Chat, models, RAG, Agent DSL, Assistant facade
implementation("com.llamatik:sdk:<version>")
// AgentRuntime: planner, permissions, audit, workflows
implementation("com.llamatik:sdk-agent:<version>")
}$ curl -N localhost:8080/v1/generation/stream \
-H "Content-Type: application/json" \
-d '{"prompt":"Say hi from my own server"}'
Llamatik Server
Brauchst du mehr Power als ein Handy? Hoste selbst einen Ktor-Server, der exakt dieselbe API spricht wie die Bibliothek — Text, Embeddings, Sprache, Bilder, Video und Vision, gestreamt per SSE.
LlamaBridge, WhisperBridge, StableDiffusionBridge und MultimodalBridgecom.llamatik:server in deine eigene App einLlamatik Code
Ein Coding-Assistent mit Privatsphäre an erster Stelle für IntelliJ IDEA, Android Studio und die JetBrains-Familie. Lade einmal ein GGUF-Modell, und dein Code verlässt nie deinen Rechner.
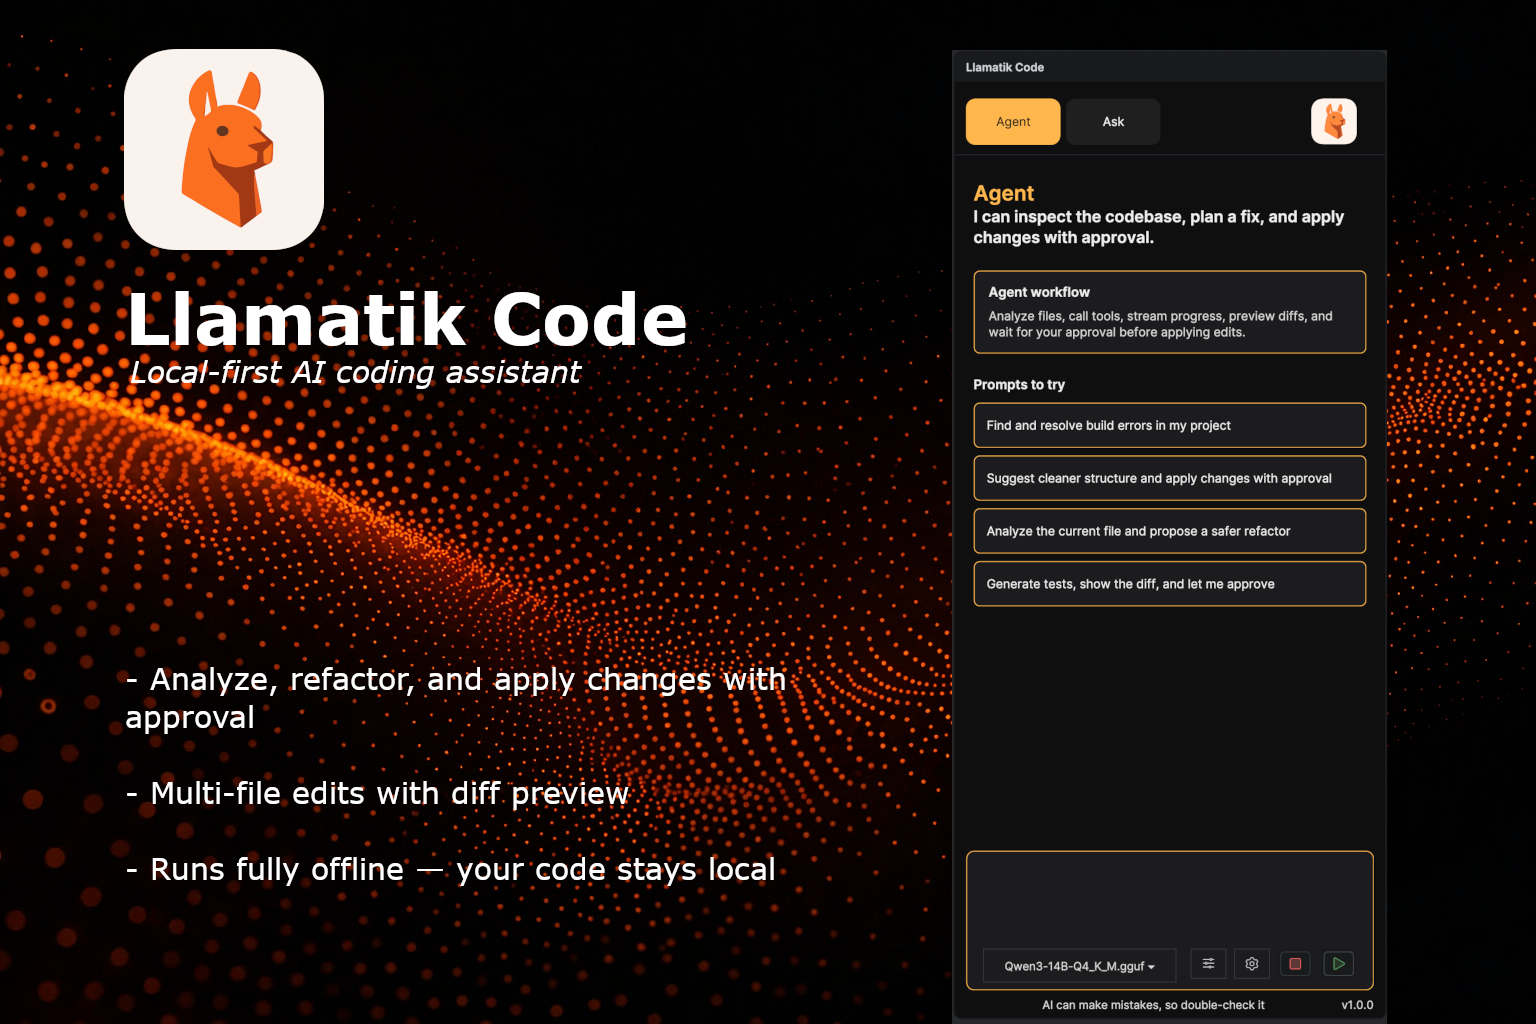
Warum local-first
Prompts, Dokumente und Sprache werden auf deiner Hardware verarbeitet. Kein Konto nötig und keine Cloud, der du vertrauen musst.
Im Flugzeug, im Keller, hinter der Firewall. Sobald ein Modell geladen ist, ist das Netzwerk optional.
MIT-lizenziert und offen entwickelt. Anschauen, forken, ausliefern. Ausgezeichnet mit einem Kotlin Foundation Grant 2026.
Was Nutzer sagen
“INCROYABLE !!!! MERCI AU DÉVELOPPEUR🤩 cette application gratuit illimitée sans soucis sans pub marche en hors ligne merci beaucoup je mettrai 10 étoiles si je pouvais”
“muito bom, cumpre oque promete! … Mas o app cumpre exatamente oque diz você consegue ter acesso a ia sem Internet.”
“love it, just like the library <3 thanks for your work”
“superb local integration functions on Oppo android device.”
Auszüge aus öffentlichen Google-Play-Rezensionen, in der Originalsprache und nur mit Vornamen. Es ist eine Auswahl der positivsten; die vollständige, ungefilterte Liste findest du im Store.
Vergleich
Ein ehrlicher Blick auf Llamatik neben den Tools, die man üblicherweise in Betracht zieht. Cloud-Modelle sind leistungsstärker; Llamatik tauscht etwas Rohleistung gegen Privatsphäre, Offline-Nutzung und Kontrolle.
| Funktion | Llamatik | Ollama | LM Studio | llama.app | ChatGPT | Claude |
|---|---|---|---|---|---|---|
| Läuft komplett auf deinem Gerät | Ja | Ja | Ja | Ja | Nein | Nein |
| Funktioniert offline | Ja | Ja | Ja | Ja | Nein | Nein |
| Native Android- und iOS-Apps | Ja | Nein | Nein | Nein | Ja | Ja |
| Führt das Modell in einem Browser-Tab aus | Ja | Nein | Nein | Nein | Nein | Nein |
| Bild-, Sprach- und Bilderzeugung auf dem Gerät | Ja | Teilweise | Teilweise | Teilweise | Nein | Nein |
| Open Source | Ja | Ja | Teilweise | Ja | Nein | Nein |
| Einbettbares Kotlin-Multiplatform-SDK | Ja | Nein | Nein | Nein | Nein | Nein |
| Modelle eines Geräts mit deinen anderen Geräten teilen | Ja | Teilweise | Teilweise | Nein | Nein | Nein |
| Kein Konto nötig | Ja | Ja | Ja | Ja | Teilweise | Nein |
| Kostenlos nutzbar | Ja | Ja | Ja | Ja | Teilweise | Teilweise |
| Modellqualität auf Spitzenniveau | Nein | Teilweise | Teilweise | Teilweise | Ja | Ja |
Basiert auf öffentlichen Informationen, Stand November 2026. Produkte ändern sich schnell: Ist etwas veraltet, schreib uns an info@llamatik.com und wir korrigieren es.
Der Llamatik-Blog
Llamatik wurde als Gewinner eines Kotlin Foundation Grants 2026 ausgewählt. Erfahre, wie diese Auszeichnung KI auf dem Gerät, die Entwicklung mit Kotlin Multiplatform und lokale KI-Agenten voranbringt.

Llamatik Code ist ein Local-first-KI-Coding-Assistent für IntelliJ-basierte IDEs. Die gesamte Inferenz läuft mit GGUF-Modellen auf deinem Rechner – keine Cloud, keine API-Keys, keine Daten, die dein Gerät verlassen.

Dieser Artikel zeigt, wie du LLMs offline auf Android mit Kotlin ausführst – ohne Server, ohne API-Keys und mit vollem Datenschutz für deine Nutzer. Dafür nutzt du Llamatik, einen Kotlin-first-Wrapper um llama.cpp.
Stell in Sekunden deine erste Frage — ohne Registrierung.